DocLayNet em 10%: ablação de data augmentationDocLayNet at 10%: a data augmentation ablation
Material suplementar do artigo final da disciplina MAC5768 do IME-USP, "Data augmentation ajuda na análise de layout de documentos? Um estudo empírico sobre o DocLayNet em escala reduzida". Os autores do DocLayNet (KDD'22) especulam que seus baselines se beneficiariam de data augmentation, mas não fazem esse experimento. Este estudo preenche essa lacuna. Supplementary material for the final paper of IME-USP's MAC5768 course, "Does data augmentation help document layout analysis? An empirical study on DocLayNet at reduced scale" (in Portuguese). The DocLayNet authors (KDD'22) speculate that their baselines would benefit from data augmentation but never run that experiment. This study fills that gap.
Ver no GitHubView on GitHub Ler o artigo (PDF)Read the paper (PDF)MétodoMethod
- Mask R-CNN R50 do Detectron2 na configuração do artigo original, exceto pelo flip horizontal, desabilitado por ser inadequado a texto, que tem orientação canônica.Detectron2's Mask R-CNN R50 in the original paper's configuration, except for horizontal flip, disabled because text has a canonical orientation.
- Cerca de 10% do dataset de treino, amostrado por documento inteiro e estratificado por tipo de documento, com seed fixa.About 10% of the training set, sampled by whole document and stratified by document type, with a fixed seed.
- Três famílias de augmentation pensadas para documento escaneado: geométrica (afim leve com fundo branco), fotométrica (brilho, contraste, gama, ruído) e filtros por convolução (blur, sharpen, erosão/dilatação).Three augmentation families designed for scanned documents: geometric (light affine with white fill), photometric (brightness, contrast, gamma, noise) and convolution filters (blur, sharpen, erosion/dilation).
- Baseline treinado três vezes para estimar a barra de erro. Avaliação sempre no val completo (6.489 páginas), mAP@0.5:0.95 de bbox, a mesma métrica do artigo.Baseline trained three times to estimate the error bar. Evaluation always on the full val set (6,489 pages), bbox mAP@0.5:0.95, the same metric as the paper.
- Treinos em 2× RTX 3090 Ti (cerca de 16 h para a fila da ablação). Cada rodada grava sua configuração resolvida e sua seed.Training on 2× RTX 3090 Ti (about 16 h for the ablation queue). Each run records its resolved config and seed.
Resultados da ablaçãoAblation results
| Augmentation | mAP | Δ vs baselineΔ vs baseline |
|---|---|---|
| nenhuma (baseline, 3 seeds)none (baseline, 3 seeds) | 61,7 ± 0,561.7 ± 0.5 | — |
| fotométricaphotometric | 62,262.2 | +0,5 (dentro do ruído)+0.5 (within noise) |
| convoluçãoconvolution | 61,061.0 | −0,7 (na borda do ruído)−0.7 (at the edge of noise) |
| geométricageometric | 59,859.8 | −1,9−1.9 |
| todas (2 seeds)all (2 seeds) | 58,258.2 | −3,5−3.5 |
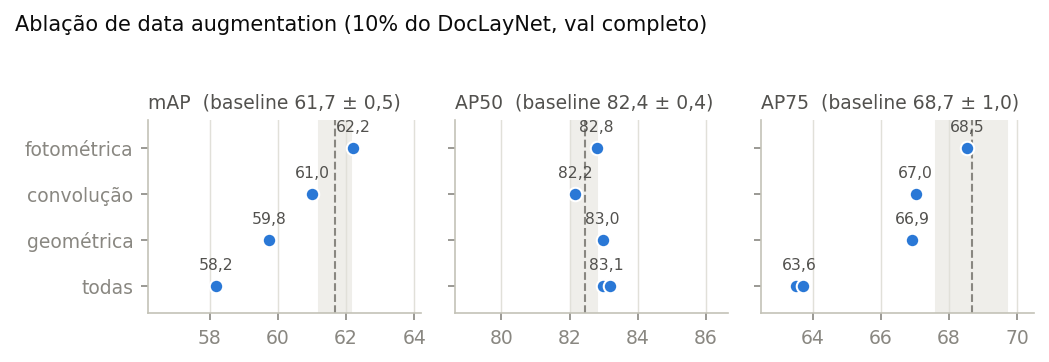
Nenhuma família melhora o resultado. A degradação se concentra no AP75, enquanto o AP50 fica estável ou levemente acima do baseline, o que indica perda de precisão de localização, e não de capacidade de detecção. No family improves the result. The degradation is concentrated in AP75, while AP50 stays stable or slightly above the baseline, which points to a loss of localization precision rather than of detection ability.
Vazamento: split por documento vs por páginaLeakage: document-level vs page-level split
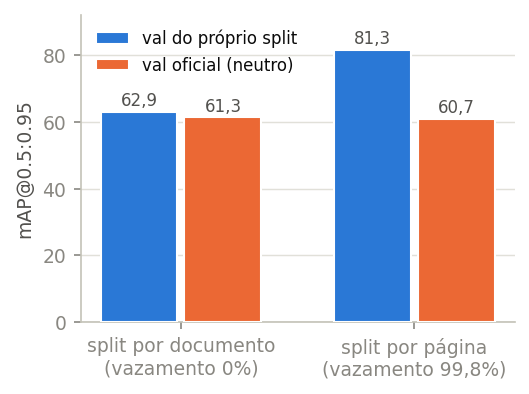
O estudo reproduz o experimento de vazamento do artigo original, acrescentando um controle num conjunto neutro. Particionar os mesmos dados por página, em vez de por documento, infla o mAP em 18,4 pontos na validação interna (81,4 contra 62,9), mas os dois modelos ficam indistinguíveis quando avaliados no val oficial (60,7 contra 61,3). The study reproduces the original paper's leakage experiment, adding a control on a neutral set. Splitting the same data by page instead of by document inflates mAP by 18.4 points on the internal validation (81.4 vs 62.9), yet both models are indistinguishable when evaluated on the official val set (60.7 vs 61.3).
ConclusãoConclusion
Para páginas digitais limpas como as do DocLayNet, augmentation que simula degradação de digitalização não ajuda, e o protocolo de particionamento pesa mais sobre a métrica do que qualquer intervenção feita no treino. For clean digital pages like DocLayNet's, augmentation that simulates scanning degradation does not help, and the splitting protocol weighs more on the metric than any training intervention we made.
ReproduçãoReproduction
# subset de treino determinístico (seed 42)deterministic training subset (seed 42)
$ python scripts/sample_fraction.py \
    --coco data/DocLayNet_core/COCO/train.json \
    --fraction 0.10 --seed 42 --out data/subsets/train_10pct_seed42

# fila da ablação, uma instância por GPUablation queue, one instance per GPU
$ ./scripts/run_queue.sh 0
$ ./scripts/run_queue.sh 1

# junta os mAPs numa tabelacollect mAPs into a table
$ python scripts/collect_results.py